
Der Ausfall begann bei mir nicht mit einer SMART-Warnung oder einem spektakulären Hardware-Fehler. Ich habe zuerst einfach gemerkt, dass mein Home Assistant nicht mehr funktioniert.
Da Home Assistant bei mir virtualisiert auf Proxmox läuft, war relativ schnell klar, dass ich mir den betroffenen Node genauer ansehen musste. Die Weboberfläche des Hosts war allerdings überhaupt nicht mehr erreichbar.
Zum Glück bestand mein Homelab nicht nur aus diesem einen System. Home Assistant konnte ich relativ schnell auf einem anderen Proxmox-Node wieder hochbringen. Damit war der wichtigste Dienst erstmal wieder verfügbar. Danach begann die eigentliche Fehlersuche.

Der Proxmox-Host war komplett weg
Der betroffene Host lief auf einer einzelnen SATA-SSD mit ZFS. Im weiteren Verlauf zeigten sich typische Storage-Probleme mit Meldungen wie:
READ FPDMA QUEUED
timeout
hardresetting link
I/O error, dev sda
ZFS I/O errors
Damit war für mich klar, dass ich der SSD nicht mehr vertrauen konnte. Statt weitere Bootversuche oder Reparaturversuche direkt auf dem Originalmedium zu machen, habe ich mich für einen konservativen Weg entschieden.
Erst ein Image erstellen, dann ausschließlich mit der Kopie arbeiten.
Die Datenrettung war eigentlich nur noch ein Experiment
Ich war zum Glück nicht komplett auf die SSD angewiesen. Einen Teil meiner Systeme hatte ich als Backups auf meinem Unraid liegen. Außerdem liegen meine Docker-Compose-Konfigurationen und viele Systemkonfigurationen versioniert in meinem Gitea.
Dadurch hatte ich mehrere Wege zurück: Backups aus Unraid, reproduzierbare Deployments aus Gitea, einen zweiten Proxmox-Node für schnelle Verfügbarkeit – und als technisches Experiment die direkte Rettung aus dem alten ZFS-Pool.
Fast einen ganzen Tag SSD-Recovery mit macOS
Die alte SATA-SSD habe ich über einen SATA-USB-Adapter an meinen Mac angeschlossen. Als Ziel diente eine externe Festplatte. Unter macOS habe ich GNU ddrescue verwendet:
brew install ddrescue

diskutil list

sudo ddrescue -f -n
  /dev/rdiskX
  /Volumes/BACKUP/proxmox.img
  ~/Desktop/rescue.log
Der Vorgang lief fast einen ganzen Tag. Das ist einer der Punkte, die man bei Datenrettung gern unterschätzt: Es ist nicht unbedingt kompliziert, aber teilweise einfach langsam.
Dann kam „No space left on device“
Quelle und Ziel waren nominell beide 1 TB groß. Trotzdem passte das vollständige Image nicht auf das Dateisystem der externen Platte. Das Image war am Ende ungefähr 258 MB kleiner als der Originaldatenträger.
Zum Glück lag der fehlende Bereich am Ende des Datenträgers. Die eigentliche ZFS-Partition war vollständig im Image enthalten; betroffen war hauptsächlich die Backup-GPT am Ende des Datenträgers.
Die ZFS-Partition manuell aus dem Image öffnen
Da das Image abgeschnitten war, funktionierte eine automatische Partitionserkennung nicht sauber. Also habe ich die ZFS-Partition anhand ihrer Sektorgrenzen manuell als Loop-Device eingebunden.
LOOPZFS=$(losetup --find --show --read-only
  --offset $((2099200*512))
  --sizelimit $(((1952448512-2099200+1)*512))
  /mnt/backup/proxmox.img)

zdb -l "$LOOPZFS"
ZFS erkannte tatsächlich meinen alten Pool.
Alten ZFS-Pool nur read-only importieren
Für die Recovery wollte ich unter keinen Umständen versehentlich etwas auf dem geretteten Pool verändern. Deshalb habe ich ihn unter einem anderen Namen und ausdrücklich read-only importiert:
mkdir -p /mnt/oldrpool

zpool import -f -N
  -d "$LOOPZFS"
  -o readonly=on
  -R /mnt/oldrpool
  <POOL-GUID> oldrpool

zpool status oldrpool
Der Pool war ONLINE. Keine Read-, Write- oder Checksum-Fehler. Ab diesem Moment war klar, dass die Chancen sehr gut standen, die alten VMs und LXC-Container wiederzubekommen.

Proxmox komplett neu aufgebaut – diesmal mit ZFS-Mirror
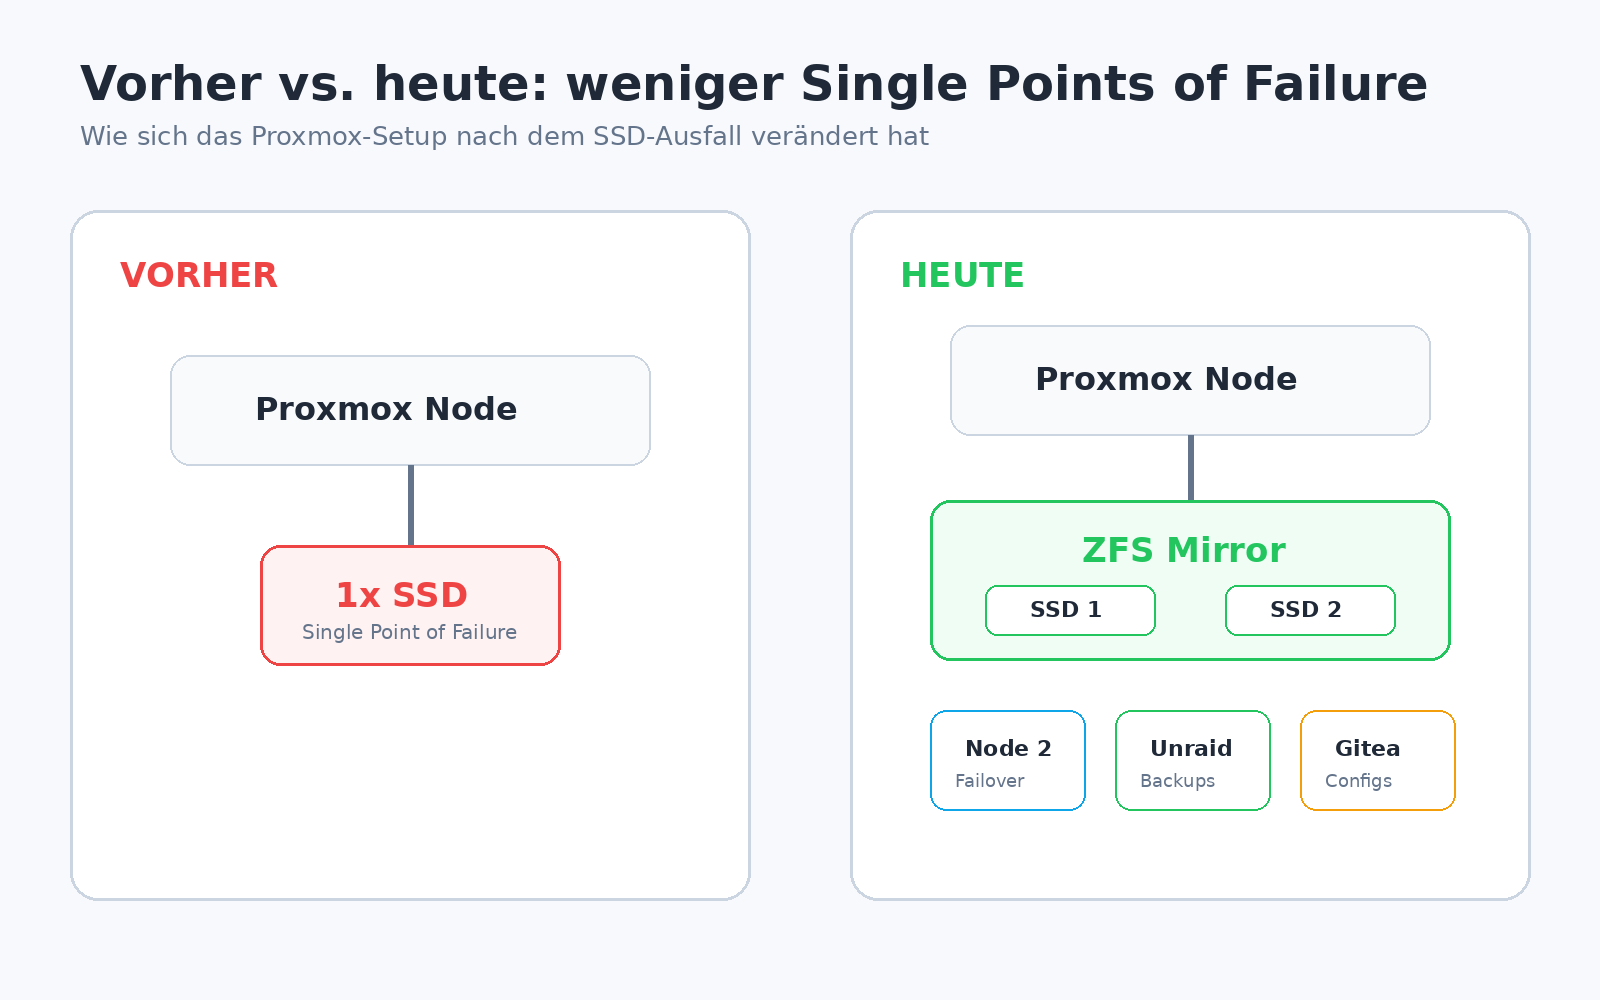
Den betroffenen Host habe ich nicht wieder mit einer einzelnen SSD aufgebaut. Das war für mich die wichtigste Konsequenz aus dem Ausfall.
Ich habe zwei neue SSDs verbaut und Proxmox direkt auf einem ZFS-Mirror installiert. Umgangssprachlich entspricht das dem, was viele als RAID1 bezeichnen: Die Daten liegen gespiegelt auf beiden Laufwerken.
Wenn künftig eine einzelne SSD ausfällt, bedeutet das damit nicht automatisch wieder den kompletten Verlust des Hosts. Ein Mirror ersetzt weiterhin kein Backup – aber er beseitigt genau den Single Point of Failure, der mir hier wehgetan hat.
Der Cluster hat mir trotzdem sehr geholfen
Auch wenn der Storage-Ausfall auf einem Node unangenehm war, hat mir mein zweiter Proxmox-Node direkt geholfen. Home Assistant konnte ich schnell wieder auf einem anderen Node starten.
Das war praktisch der Unterschied zwischen „Mein Smart Home ist komplett weg“ und „Mein Smart Home läuft wieder, jetzt kann ich mich in Ruhe um den kaputten Host kümmern“.
Ein Cluster ersetzt keine Backups, aber er kann die Ausfallzeit wichtiger Dienste massiv reduzieren.
Backups auf Unraid und Konfiguration in Gitea
Ein Teil meiner Systeme lag zusätzlich als Backup auf meinem Unraid. Dadurch war ich auch bei einigen anderen VMs und Containern nicht auf die defekte SSD angewiesen.
Ein weiterer Punkt, der sich extrem ausgezahlt hat: Meine Docker-Compose-Konfigurationen und Systemkonfigurationen liegen in meinem Gitea. Selbst wenn ein LXC-Container komplett verloren gegangen wäre, hätte ich viele Dienste anhand meiner Compose-Dateien wieder neu deployen können.
Redundanz schützt vor Ausfall. Backups schützen vor Datenverlust. Git schützt vor verlorener Konfiguration und vergessenem Wissen.
Eine VM direkt aus dem alten ZFS-Image retten
Eine der alten VMs lag als ZVOL im Pool. Für VM 1591 hatte die virtuelle Disk 50 GB und eine volblocksize von 16K. Auf dem neuen Pool habe ich deshalb ein passendes Sparse-ZVOL angelegt:
zfs create -s -V 50G -b 16K
  rpool/data/vm-1591-disk-0

dd
  if=/dev/zvol/oldrpool/data/vm-1591-disk-0
  of=/dev/zvol/rpool/data/vm-1591-disk-0
  bs=16M
  status=progress
  conv=fsync
Das war über die externe Platte nicht besonders schnell, funktionierte aber zuverlässig.
LXC-Container brauchen einen anderen Weg
Bei LXC sieht die Sache anders aus. Proxmox verwendet auf ZFS dafür normale Datasets wie subvol-1595-disk-0 oder subvol-1593-disk-0.
Für einen Container habe ich zunächst ein neues Dataset mit passender Quota, POSIX-ACLs und Extended Attributes angelegt:
zfs create
  -o mountpoint=/rpool/data/subvol-1595-disk-0
  -o acltype=posixacl
  -o xattr=sa
  -o refquota=5G
  rpool/data/subvol-1595-disk-0
Anschließend wurden die Daten mit rsync übertragen:
rsync -aHAX --numeric-ids --info=progress2
  /pfad/zum/alten/subvol/
  /rpool/data/subvol-1595-disk-0/
Gerade bei unprivilegierten LXC-Containern ist --numeric-ids wichtig, damit UID- und GID-Zuordnungen erhalten bleiben.
Auch bei der Recovery lief nicht alles glatt
Beim ersten Versuch hatte ich ein LXC-Dataset an den falschen Mountpoint gehängt. Dadurch scheiterte Proxmox beim Start mit:
cannot open directory //rpool/data/subvol-1595-disk-0:
No such file or directory
Nach Korrektur des Mountpoints startete der Container wieder:
zfs set mountpoint=/rpool/data/subvol-1595-disk-0
  rpool/data/subvol-1595-disk-0
Nach dem Ausfall bin ich besser aufgestellt als vorher
- ZFS-Mirror: Eine einzelne defekte SSD nimmt den Host nicht mehr sofort komplett mit.
- Zweiter Proxmox-Node: Wichtige Dienste wie Home Assistant können schnell wieder laufen.
- Unraid: Backups liegen auf einem anderen System.
- Gitea: Docker-Compose- und Systemkonfigurationen bleiben reproduzierbar.
- Recovery-Wissen: Ich weiß jetzt, dass sich ein Proxmox-ZFS-Pool selbst aus einem nicht ganz vollständigen Disk-Image noch erstaunlich gut retten lässt.
Was ich aus der Geschichte gelernt habe
Ein ZFS-Mirror ist kein Backup
Aber er verhindert, dass eine einzelne kaputte SSD direkt den ganzen Host mitnimmt.
Ein zweiter Proxmox-Node lohnt sich
Home Assistant war schnell wieder online, obwohl der ursprüngliche Host komplett ausgefallen war.
Backups sollten auf einem anderen System liegen
Meine Unraid-Backups waren von dem SSD-Ausfall überhaupt nicht betroffen. Genau so sollte es sein.
Konfiguration gehört in Git
Docker Compose und Systemkonfigurationen in Gitea haben den Wiederaufbau deutlich entspannter gemacht.
Bei kaputten Datenträgern erst sichern
Nicht direkt reparieren, nicht ständig neu booten und nicht unnötig schreiben. Erst ein Image erstellen und danach mit der Kopie arbeiten.
Fazit
Der ganze Vorfall begann ziemlich banal: Home Assistant war plötzlich nicht mehr erreichbar. Kurz darauf stellte sich heraus, dass der komplette Proxmox-Node nicht mehr über die Weboberfläche erreichbar war und die SSD massive Probleme verursachte.
Zum Glück war mein Homelab bereits teilweise redundant aufgebaut. Home Assistant lief schnell wieder auf einem anderen Node, Backups lagen auf Unraid und meine Docker- und Systemkonfigurationen lagen in Gitea.
Die Rettung der alten SSD war deshalb am Ende eher ein interessantes Recovery-Projekt als ein letzter verzweifelter Versuch, meine Infrastruktur zu retten.
Und genau daraus ist für mich die wichtigste Verbesserung entstanden: Der Proxmox-Host läuft jetzt auf zwei SSDs als ZFS-Mirror.
Zusammen mit dem zweiten Proxmox-Node, externen Backups und versionierter Konfiguration bin ich damit deutlich besser aufgestellt als vor dem Ausfall.