Mein Homelab ist über die letzten Jahre Stück für Stück gewachsen.
Nicht nach einem großen Masterplan. Ein neuer Dienst kam dazu, dann ein weiterer Server, mehr Smart-Home-Geräte, eine Palo-Alto-Firewall, Proxmox, Unraid und schließlich ein zweiter Internetanschluss.
Inzwischen ist der Punkt erreicht, an dem „läuft doch“ als Monitoring nicht mehr reicht.
Mein Homelab ist inzwischen echte Infrastruktur
Bei mir laufen unter anderem Proxmox, VMs, LXC-Container, Unraid, Home Assistant, eine Palo-Alto-Firewall und Access Points.
Allein von Shelly sind inzwischen ungefähr 70 Geräte im Einsatz.
Dazu kommen zwei Internetanschlüsse: mein Hauptanschluss und Starlink als zweiter, möglichst unabhängiger WAN-Link.
Solange alles funktioniert, ist das angenehm unspektakulär. Interessant wird es erst, wenn etwas nicht funktioniert.
Was war eigentlich gerade kaputt?
War das Internet weg? Hatte nur Starlink Probleme? Gab es Paketverlust? Hat die Palo Alto den WAN-Link gewechselt? Ist ein LXC ausgefallen? Ist Home Assistant das Problem oder nur ein einzelnes Gerät?
Viele dieser Fragen kann ich heute irgendwie beantworten. Aber nicht zentral, nicht sauber und vor allem nicht rückwirkend.
Genau die Historie fehlt mir.
Besonders wichtig: meine beiden Internetanschlüsse
Ein einfacher Ping mit „erreichbar“ oder „nicht erreichbar“ reicht mir nicht.
Ich möchte langfristig sehen können, wann welcher Anschluss ausgefallen ist, wie hoch Latenz, Paketverlust und Jitter waren und ob es Unterschiede nach Tageszeit gibt.
Außerdem möchte ich nachvollziehen können, wann SD-WAN tatsächlich auf den anderen Anschluss gewechselt hat und wie lange eine Störung gedauert hat.
Gerade bei Starlink interessiert mich nicht nur ein einzelner Speedtest. Ich möchte nach einigen Wochen echte Daten haben und Hauptanschluss und Starlink miteinander vergleichen können.
Server, Netzwerk und Smart Home gehören ebenfalls dazu
Auf der Server-Seite möchte ich Proxmox, VMs, LXC und Unraid im Blick behalten. Später sollen Netzwerkgeräte wie Switches und Access Points dazukommen.
Auch das Smart Home ist inzwischen groß genug, dass Muster interessant werden: Welche Geräte verschwinden regelmäßig? Welche wichtigen Dienste sind nicht erreichbar? Gibt es Probleme, die immer wieder auftreten?
Dabei will ich aber nicht jedes meiner rund 70 Shelly-Geräte mit zehn sinnlosen Checks überwachen. Das Monitoring soll helfen und nicht selbst zum Vollzeitprojekt werden.
Was ich suche
Mein Referenzpunkt ist das Prinzip hinter PRTG: ein zentrales System, Geräte und Dienste überwachen, historische Daten behalten, Alarme bekommen und vernünftige Dashboards bauen.
Diesmal möchte ich das möglichst flexibel, modern und ohne unnötige laufende Kosten aufbauen.
Wichtig sind mir unter anderem langfristige Historien, SNMP, automatische Erkennung, Alarmierung, gute Dashboards und die Möglichkeit, das Ganze später problemlos zu erweitern.
Noch ist kein Tool gesetzt
Ich könnte jetzt einfach Checkmk installieren und anfangen.
Genau das möchte ich diesmal nicht machen.
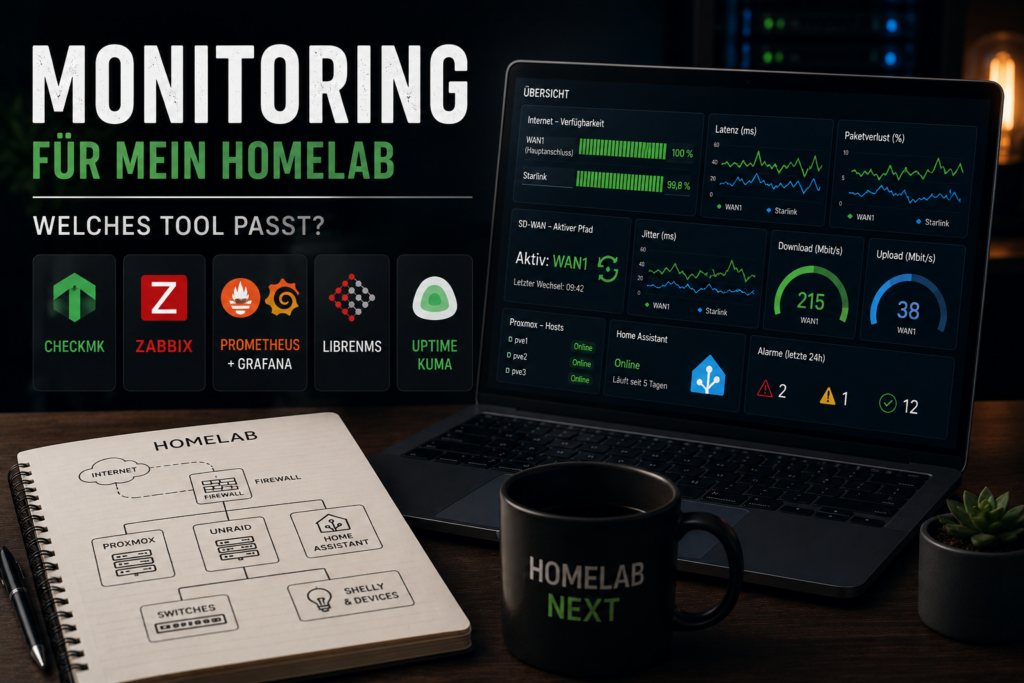
Auf der Liste stehen aktuell unter anderem Checkmk, Zabbix, Prometheus mit Grafana, LibreNMS und Uptime Kuma.
Vielleicht gewinnt am Ende ein einzelnes System. Vielleicht ist eine Kombination sinnvoller.
Die Entscheidung soll aber aus meinen Anforderungen entstehen und nicht daraus, welches Tool ich gerade am besten kenne.
Der Aufbau wird Teil der Serie
Ich möchte diesmal nicht nur das fertige Dashboard zeigen.
Wenn SNMP Probleme macht, ein Gerät nicht sauber erkannt wird, ein Alarm nach zwei Tagen nervt oder wir eine Architekturentscheidung wieder ändern müssen, gehört das ebenfalls dazu.
Das Monitoring entsteht Schritt für Schritt – und genau diesen Weg dokumentiere ich hier.
Im nächsten Teil geht es deshalb noch nicht um die Installation, sondern um die entscheidende Frage:
Checkmk, Zabbix, Grafana oder doch etwas anderes – welches Monitoring passt wirklich zu meinem Homelab?